我们先来看这样一个故事:
程序员加班回家,已经是深夜了,加上路途遥远,只好坐车回去,他现在想到的交通工具如下。
1 | costs = ['bike', 'car', 'bus', 'light railway'] |
程序员想了想:
1 | for cost in costs: |
各种交通工具的价格已经贴在墙上了:
1 | costs = [['bike', 2], ['car', 10], ['bus', 5], ['light railway', 6]] |
于是他又尝试了之前的方法:
1 | for cost in costs: |
得到了如下结果: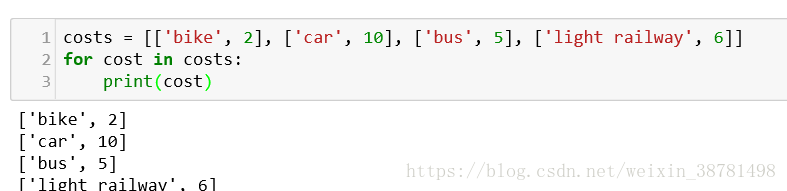
但是这次他对结果似乎不太满意,他要把这个变成字典形式。
1 | costs = [['bike', 2], ['car', 10], ['bus', 5], ['light railway', 6]] |
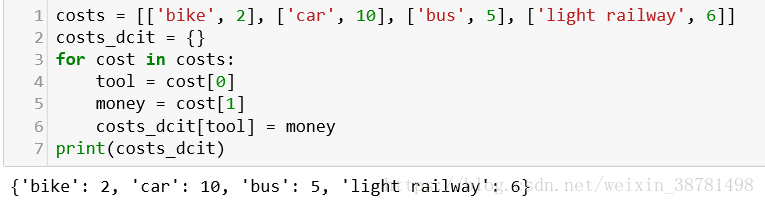
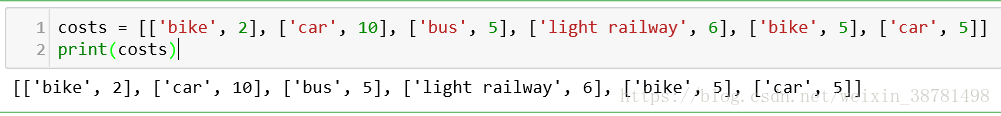
看到这他似乎终于露出了笑容,不过又遇到了新的问题。由于雨天的原因,自行车坏了,还要花费额外的5元去换一个零件,而到了深夜,出租车也开始涨价了。
结果就变成这个样子:
1 | costs = [['bike', 2], ['car', 10], ['bus', 5], ['light railway', 6], ['bike', 5], ['car', 5]] |
于是他又按照原来的方法计算:
1 | costs = [['bike', 2], ['car', 10], ['bus', 5], ['light railway', 6], ['bike', 5], ['car', 5]] |
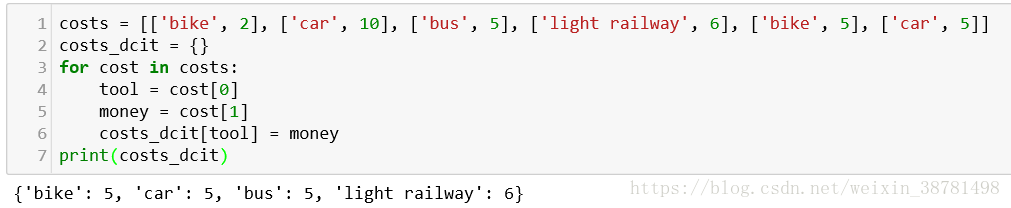
结果发现总是哪里不对劲,原来后边的添加的数据把之前的给覆盖掉了,那要怎么办呢?聪明的程序员马上就有了结果。
1 | costs = [['bike', 2], ['car', 10], ['bus', 5], ['light railway', 6], ['bike', 5], ['car', 5]] |
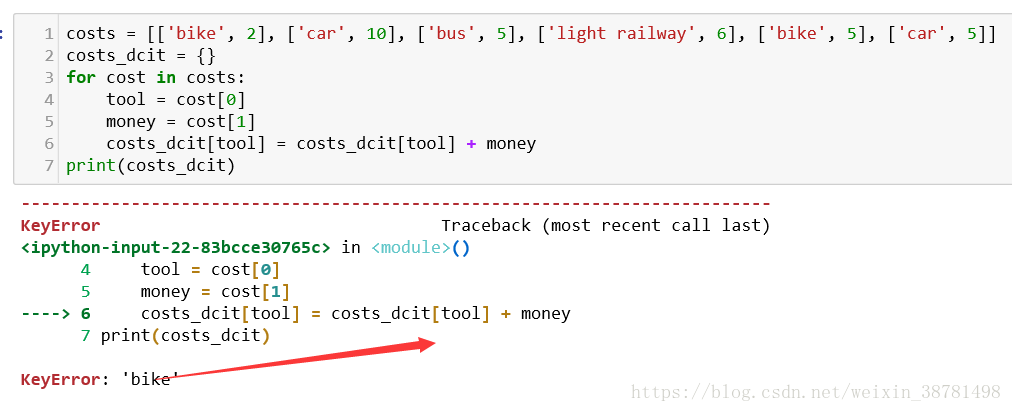
但是,貌似出了一点小bug,有个KeyError: ‘bike’的报错,原来一开始没有定义costs_dcit[tool]。是这样报的错啊。
程序员想了想,马上想出了解决方案:如果一个key之前在字典里面,就用这样的累加方法。如果不在,就给他定义赋值。
1 | costs = [['bike', 2], ['car', 10], ['bus', 5], ['light railway', 6], ['bike', 5], ['car', 5]] |
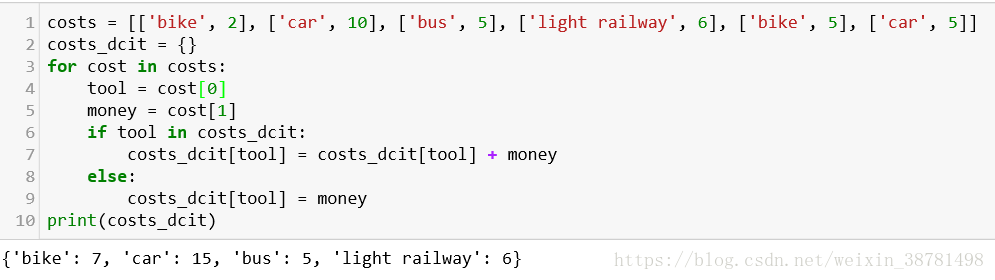
哈哈,终于解决了!距离回家更近了一步了,但是家里老婆管的严,又不让乱花钱,所以他只好选用一种最便宜的交通方式。
1 | import operator |
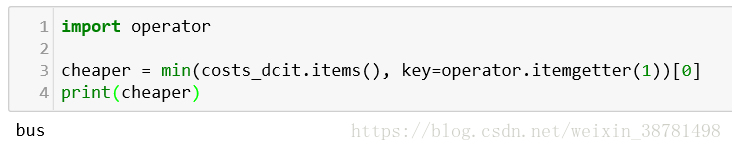
这里导入了operator, 利用itemgetter()方法进行选择比较的元素,itemgetter(1)就是比较第二个元素,也就是花费的钱数。如果itemgetter(0),就是比较交通工具了,这里也就是按照首字母的顺序来比较了。
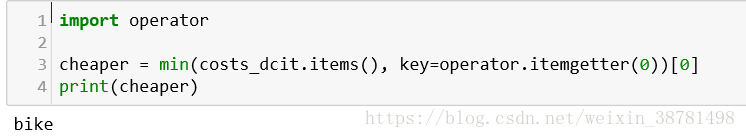
特别注意:这里min()返回的是一个tuple类型: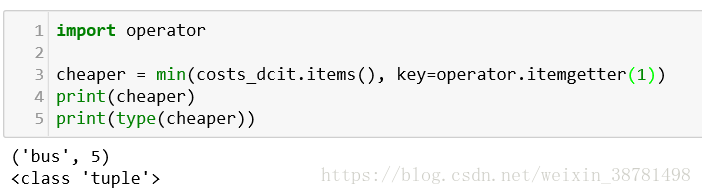
好了,程序员回家了,故事也就讲完了!
本博客所有文章除特别声明外,均采用 CC BY-NC 4.0 许可协议。转载请注明来源 镜湖!
 微信
 支付宝
评论