我用 Easysearch 搭了个「以文搜图」,然后被一盘藕片上了一课
起因很朴素:手机相册里攒了一堆美食照,想找「那次吃的海鲜汤」,翻了半天翻不到。文件名全是 IMG_20260711_135912.jpg 这种鬼东西,按时间倒是能排,可我哪记得是哪天吃的。
于是就想——能不能打一句「海鲜汤」,图自己蹦出来?
这事儿本质上叫以文搜图(text-to-image search)。手头正好有一套跑着的 Easysearch,AWS 账号也能调 Bedrock,那就折腾一下。全程真机跑通,最后还被一盘藕片教育了一顿,排查过程挺有意思,放到结尾讲。
先看成品长这样: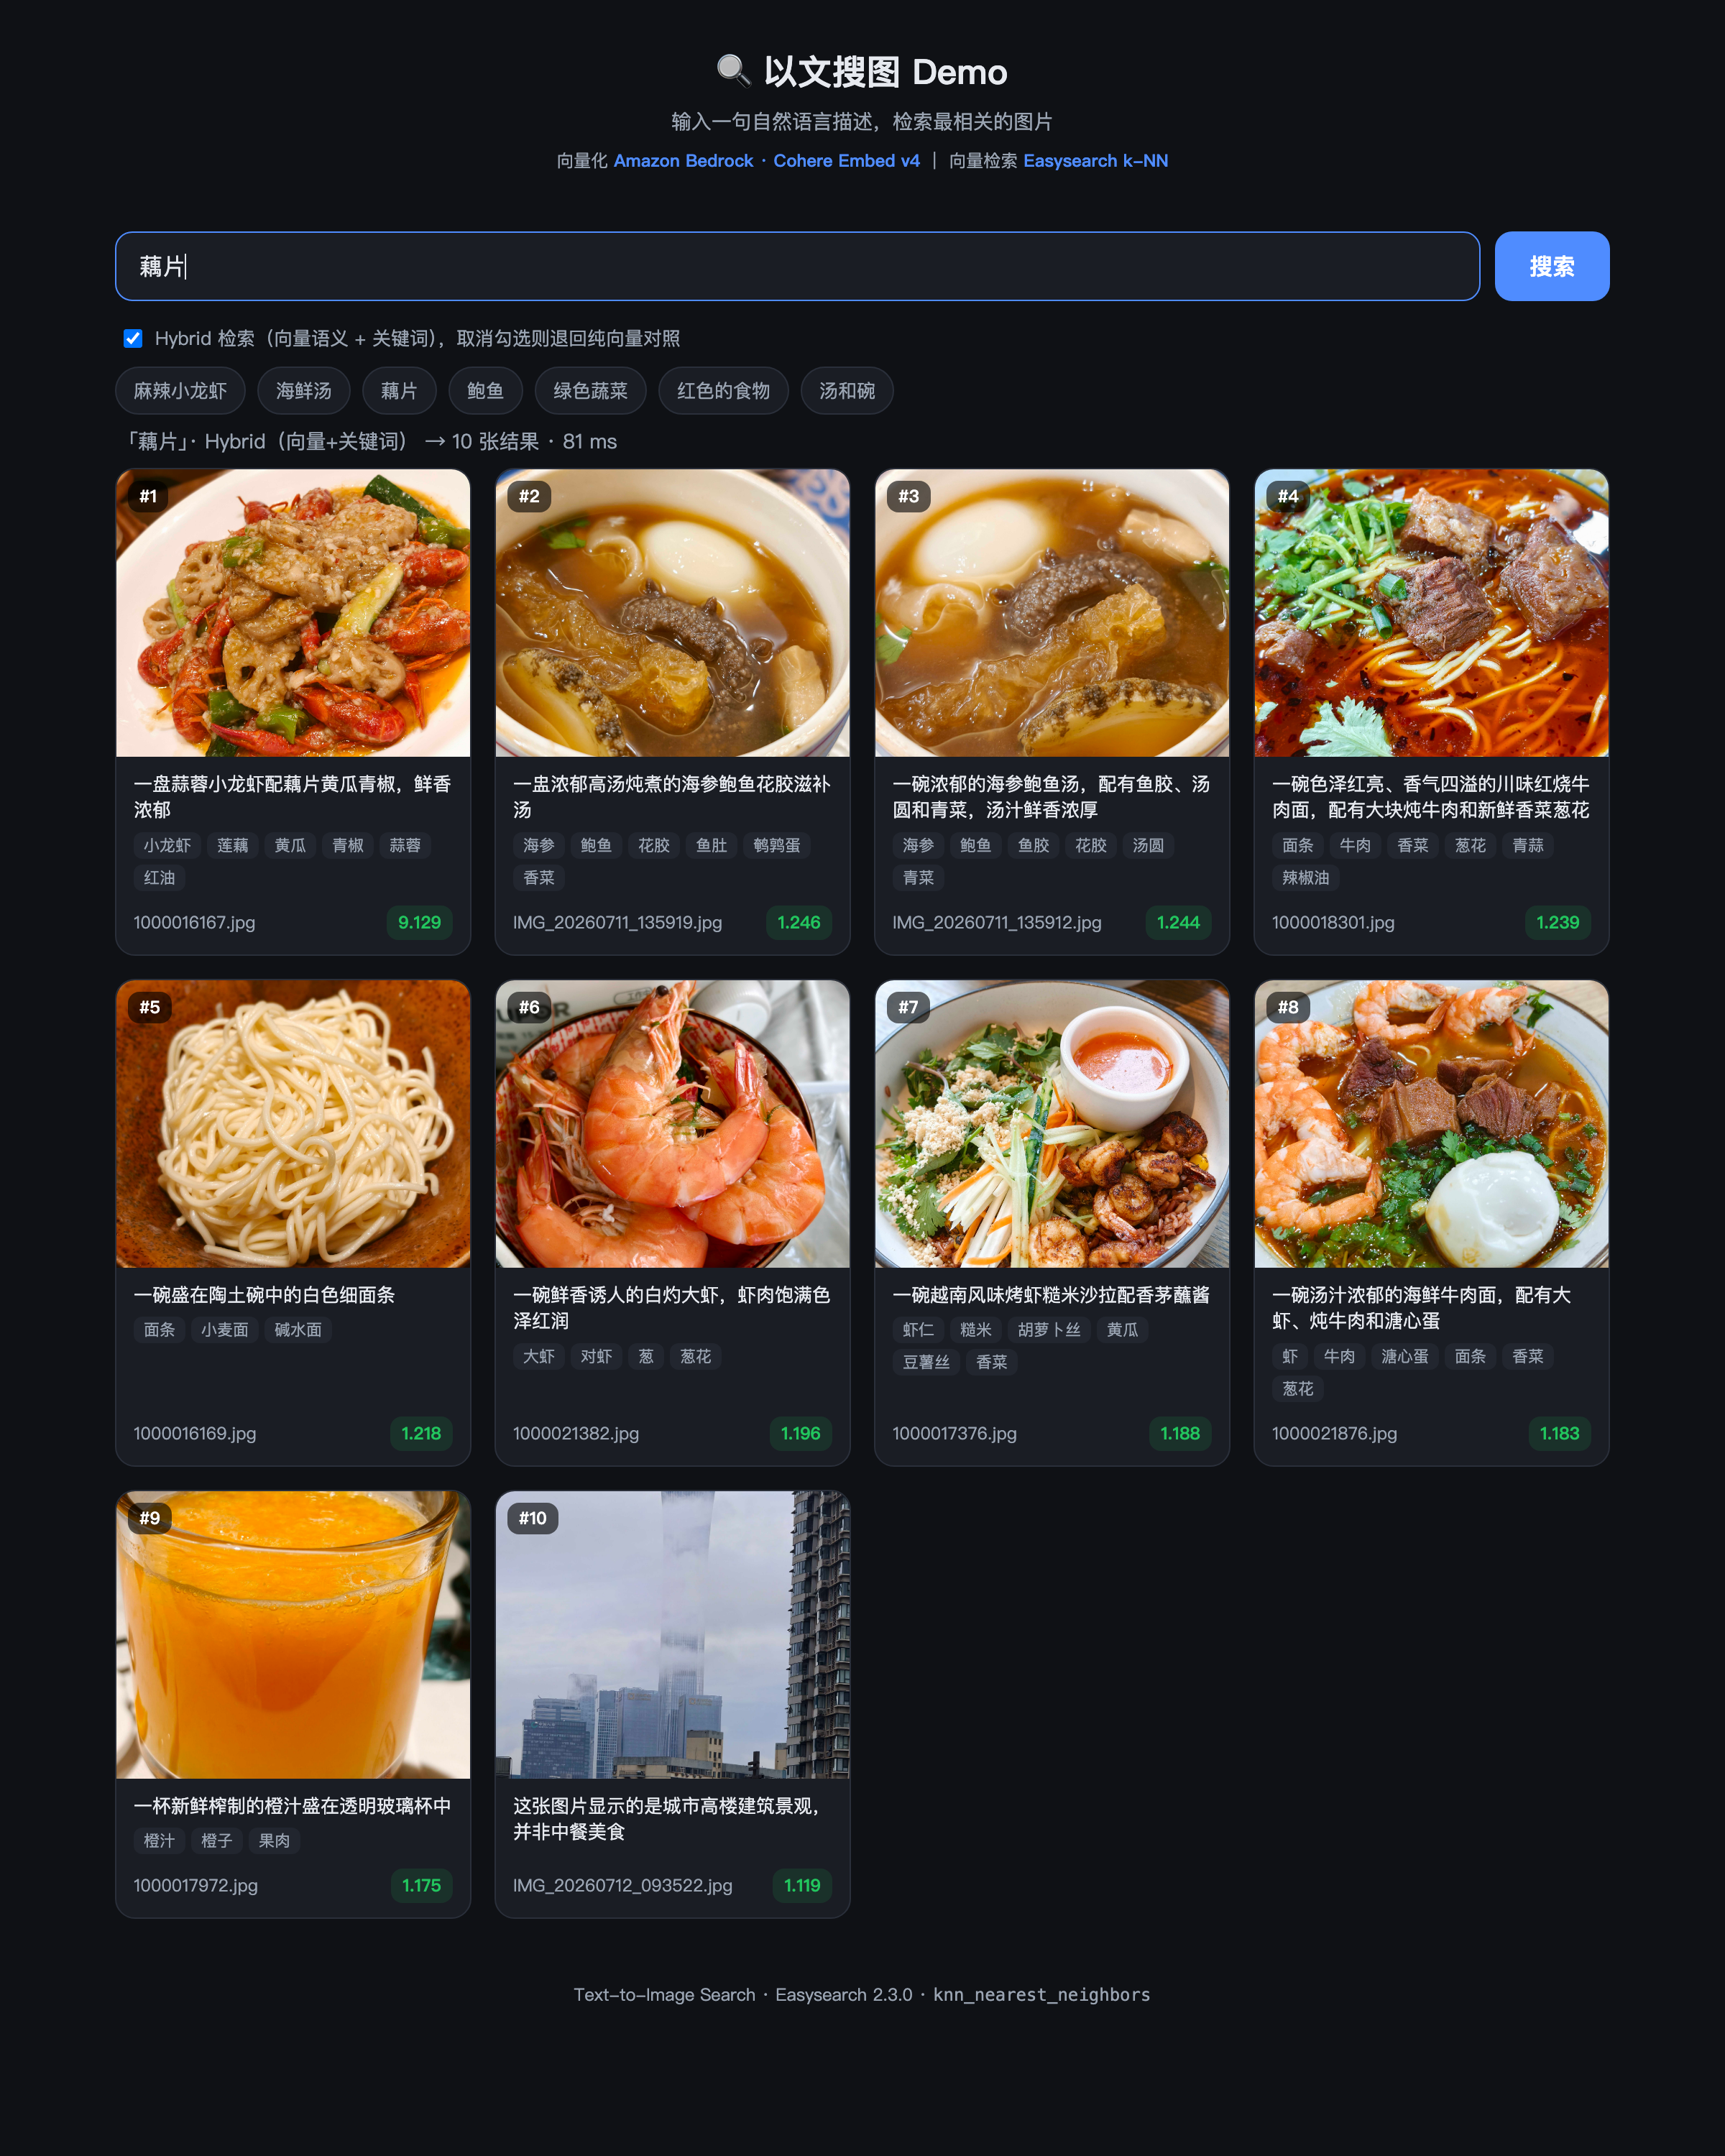
一、为什么一句话能搜到图?
先说清楚原理,不然后面都是抄命令。
关键那味料,叫多模态 embedding 模型。我用的是 Amazon Bedrock 上的 Cohere Embed v4(模型 ID cohere.embed-v4:0)。它有个本事:能把图片和文字编码到同一个 1536 维的向量空间里。
什么意思呢?说到底就一句话——内容相近的图和字,向量方向也相近。于是「一张图和一句话有多像」,就变成了「两个向量夹角有多小」,也就是余弦相似度。
以文搜图这件玄乎的事,就被降维成了一道纯粹的
向量检索
题:
1 | "麻辣小龙虾" ──Cohere Embed v4──▶ [1536维文本向量] |
空口无凭,动手前我先拿一张小龙虾的图验了一发:
- 对「麻辣小龙虾配藕片」,相似度 0.45;
- 对「雪地里奔跑的哈士奇」,相似度 0.04。
相关的明显高一大截。这就证明了:文字和图片确实落在同一个能互相比较的空间里,不是各说各话。这一步不验,后面全是空中楼阁。
一个小坑先埋着:Easysearch 里余弦相似度被映射到 [0, 2] 区间,完全相同是 2,越大越像。所以你在界面上看到的分数普遍在 1.2~1.5,别以为算错了。
二、整套架构
三个角色,各司其职:
1 | ┌──────────┐ 查询文本 ┌──────────────┐ InvokeModel ┌───────────────────────┐ |
- 前端:一个搜索框加一片结果网格,纯静态页,没有任何秘密。
- 后端:把查询文本丢给 Bedrock 换成向量,再拿这向量去 Easysearch 里
knn_nearest_neighbors一把,返回排好序的图。密码和 AWS 凭证只待在后端,绝不下发到浏览器——这条底线不能破。 - Easysearch:存向量、算 k-NN。
三、环境准备
| 依赖 | 说明 |
|---|---|
| Easysearch 2.3.0 | 自带 knn 插件 |
| Python 3.9+ | 跑 server.py / index_images.py |
| boto3 | pip3 install boto3 |
| AWS 凭证 | 能调 Bedrock InvokeModel,且已开通 cohere.embed-v4:0 |
环境变量先摆好,后面所有命令都吃它:
1 | export AWS_REGION=us-east-1 # Bedrock 所在区域 |
模型访问权限这一关别忘了——首次用要在 Bedrock 控制台的「Model access」里申请开通
Cohere
Embed v4,不然调用直接给你甩 AccessDenied。验一下模型在不在:
1 | aws bedrock list-foundation-models --region $AWS_REGION \ |
看到末尾那个 TEXT IMAGE 没有?这就是它能以文搜图的底气——两种模态它都吃。
四、第一步:建 向量索引 (这里第一个翻车)
Easysearch 的向量字段,用的是它自研的 Elastiknn 派生引擎,不是 OpenSearch 那套 knn_vector。我一开始不知道,照着 OpenSearch 的记忆写了 "type": "knn_vector",回我一句:
1 | No handler for type [knn_vector] |
主打一个翻车。查了官方文档才明白,Easysearch 密集浮点向量的字段类型叫 **knn_dense_float_vector**,参数得塞进字段内层的 knn 对象里。
数据量小(就 10 张图),我用 exact(精确)模型——暴力把查询向量和所有图向量挨个比一遍,排序 100% 准。这里又埋着第二个坑:exact 模型的映射里只写 dims,千万别写 similarity,否则又给你报 Incompatible type。相似度函数是查询时才指定的。
绕开这两个坑,建索引就顺了:
1 | curl -sk -u "admin:$ES_PASS" -XPUT "$ES_URL/image_search?pretty" \ |
⚠️ 数据量大了怎么办?
exact是 O(n²),几万张图就开始喘。这时换 LSH 近似检索,毫秒级扫百万级向量。映射改成:
1 | "embedding": { |
查询时相应把
model改成"lsh",再加个"candidates": 100(一般设成size的 5~10 倍,越大越准越慢)。
五、第二步:把图片灌进去
index_images.py 干的事很直白:遍历 images/ 目录,每张图喊一次 Cohere Embed v4 生成向量,写进 Easysearch。
1 | pip3 install boto3 # 没装的话 |
跑起来长这样:
1 | 共 10 张图片,开始向量化并写入索引 'image_search' ... |
图片向量化的关键,就一句:调 Bedrock 时 input_type 得是 **"image"**,图片本身以 data: URI(base64)塞进 images 数组。整个脚本不长,全摊在这儿——index_images.py:
1 | #!/usr/bin/env python3 |
六、第三步:跑起来
后端 server.py 只依赖标准库加 boto3,连 Flask 都省了。核心就两个函数——文本转向量 和 拿向量去检索:
1 | def embed_query(text): |
外面再包一层 http.server 提供页面、图片和 /api/search 接口就完事了(完整代码见仓库 server.py,里面顺手做了目录穿越防护——别让人拿 /images/../server.py 把你源码撬走)。
knn_nearest_neighbors 的 vec 其实有三种写法,这里只用了最常见的第一种:
{"values": [...]}——直接给向量(我们用这个);{"values": [[indices], total_dims]}——稀疏布尔向量;{"index": "...", "id": "...", "field": "..."}——引用索引里已有文档的向量。第三种拿来做「以图搜图」正合适:把上传图编码成向量,或直接引用某张已入库图的向量,一样走这个查询。
起服务:
1 | python3 server.py |
浏览器打开 http://localhost:8080,输入「海鲜汤」,回车。
结果相当能打——两碗海参鲍鱼汤稳稳排 #1、#2,分数 1.47;最不相关的那张随手拍的高楼照片,老老实实垫底 1.18。整个语义排序,服。
不想开浏览器,直接怼 API 也行:
1 | curl -s "http://localhost:8080/api/search?q=海鲜汤" | python3 -m json.tool |
1 | { |
到这儿,一个能跑的以文搜图就成了。本以为可以收工了——直到我手贱点了「藕片」。
七、然后,一盘藕片给我上了一课
搜「藕片」,结果一片凌乱。
真正那盘有藕片的图(1000016167.jpg,就是麻辣小龙虾配藕片那张),只排到 #5;反倒是几碗汤、一盘白灼虾挤在前面。当时就愣了——海鲜汤能搜得那么准,一个「藕片」怎么就翻车了?
先看现象:不只是排错,是分数整个塌了。
- 「海鲜汤」的 top1 = 1.470,模型很确信;
- 「藕片」的 top1 才 1.246,而且前十名分数全挤在 1.18~1.25 这个窄带里。
分数挤成一坨,翻译过来就是:模型觉得「这些图对藕片来说都半相关」,谁也不比谁强多少。既然没有明显赢家,排序自然就接近瞎蒙了。
再理怀疑方向:为什么整体准、局部就抓瞎?
我的第一直觉是——问题出在「藕片」是局部小物体。Cohere Embed v4 给整张图只生成一个向量,代表的是整图语义:这盘菜整体是什么。而 1000016167.jpg 那张,整体是麻辣小龙虾,藕片只是配菜,占画面可能就一成。于是它的向量主要指向「小龙虾、红油」,「藕片」这个局部特征,被整盘菜的浓墨重彩稀释掉了。
直觉归直觉,得验。于是做了组对照实验:同一张目标图,换不同的查询词,看它能排到第几。
| 查询词 | 小龙虾藕片图的排名 | top1 分数 |
|---|---|---|
| 藕片 | #5 | 1.20(全挤一起) |
| 莲藕 | #3 | 1.30 |
| 小龙虾配藕片 | #1 ✅ | 1.44 |
| lotus root slices | #3 | 1.22 |
| crayfish with lotus root | #1 ✅ | 1.53 |
真相大白。
根因:不是系统的锅,是查询词的锅。
只要查询词描述的是整盘菜的样子(「小龙虾配藕片」而不是孤零零一个「藕片」),目标图立刻精准弹到 #1,分数从 1.20 一路拉到 1.53。这就坐实了前面的判断——模型编码的是整图语义,你得站在「这盘菜整体长啥样」的角度去描述它,而不是揪着一个占画面一成的配菜死磕。
顺带还看出:「藕片」这种中文细粒度食材词,模型见得比「soup」「shrimp」少,向量本就不稳;英文的 crayfish with lotus root 反而拿了全场最高分 1.53。这也是意料之中——多模态模型的英文语料终究更厚。
八、那要怎么治?
这不是 bug,是「单向量整图检索」的娘胎里带的病。生产系统里,一般这么补:
方案 A(最实用)——给每张图预生成描述,做 Hybrid 检索。 灌图时顺手让个
多模态大模型
(比如 Claude)给每张图写句描述、打几个标签(["小龙虾","藕片","青椒","香辣"]),存成 text 字段。搜「藕片」时,knn_nearest_neighbors(向量)加 match(BM25 关键词)两路一起打分融合。这样「藕片」哪怕只是配菜,也能靠关键词精确命中。Easysearch 原生就支持这种混合查询——这是让 demo 从「能跑」变「好用」的关键一跳。
方案 B——查询侧扩展。 后端把用户那个干巴巴的短词,先喂给
LLM
扩写成一句完整描述(「藕片」→「一盘有藕片的菜」)再去编码。等于自动替用户做了上面对照实验里那件事。
方案 C——换更强或更专的模型。 比如对中文食材更敏感的中文多模态模型。
我打算下一篇把方案 A 补上,正好能把 Hybrid 检索讲透。
附一:前端就一个 fetch
前端没什么玄机,一个搜索框加一片网格,核心逻辑就是把输入 fetch 给后端、拿结果渲染成卡片(完整页面含样式见仓库 index.html):
1 | async function search() { |
密码、AWS 凭证、Easysearch 地址,全在后端,前端从头到尾只知道一个 /api/search。这条线不能松。
附二:文件清单与一键复现
| 文件 | 作用 |
|---|---|
index_images.py | 把 images/ 下的图向量化并写入 Easysearch |
server.py | Web 后端:文本向量化 + k-NN 检索 + 提供页面/图片 |
index.html | 前端单页:搜索框 + 结果网格 |
images/ | 图库(本例是 10 张美食图) |
README.md | 本文 |
1 | export AWS_REGION=us-east-1 |
搞了一圈下来,最大的收获反倒不是「搭成了」,而是那盘藕片——它提醒我,向量检索这东西看着玄乎,骨子里还是「你怎么描述,它怎么给」。整图语义和局部细节之间那道坎,模型自己迈不过去,得靠工程手段搭桥。
下一篇,就来搭这座桥。
技术栈:INFINI Labs Easysearch 2.3.0(
knn_nearest_neighbors)· Amazon Bedrock Cohere Embed v4 · Python 标准库 HTTP 服务
 微信
 支付宝